
基因法分片实战
https://developer.aliyun.com/article/1256632
https://developer.aliyun.com/article/1575638
https://developer.aliyun.com/article/1082388
通过索引表的方式,虽然存储上较冗余全表容量小了很多,但是要根据另一个分片键进行数据的存储,还是显得不够优雅。 因此,最优的设计,不是创建一个索引表,而是将分片键的信息保存在想要查询的列中,这样通过查询的列就能直接知道所在的分片信息,这种方法也叫叫做基因法。 基因法的原理出自一个理论:对一个数取余2的n次方,那么余数就是这个数的二进制的最后n位数。 假如我们现在根据user_id进行分片,采用 (user_id % 16) 的方式来进行数据库路由,这里的 user_id%16,其本质是user_id的最后4个bit位 log(16,2) = 4 决定这行数据落在哪个分片上,这4个bit就是分片基因。
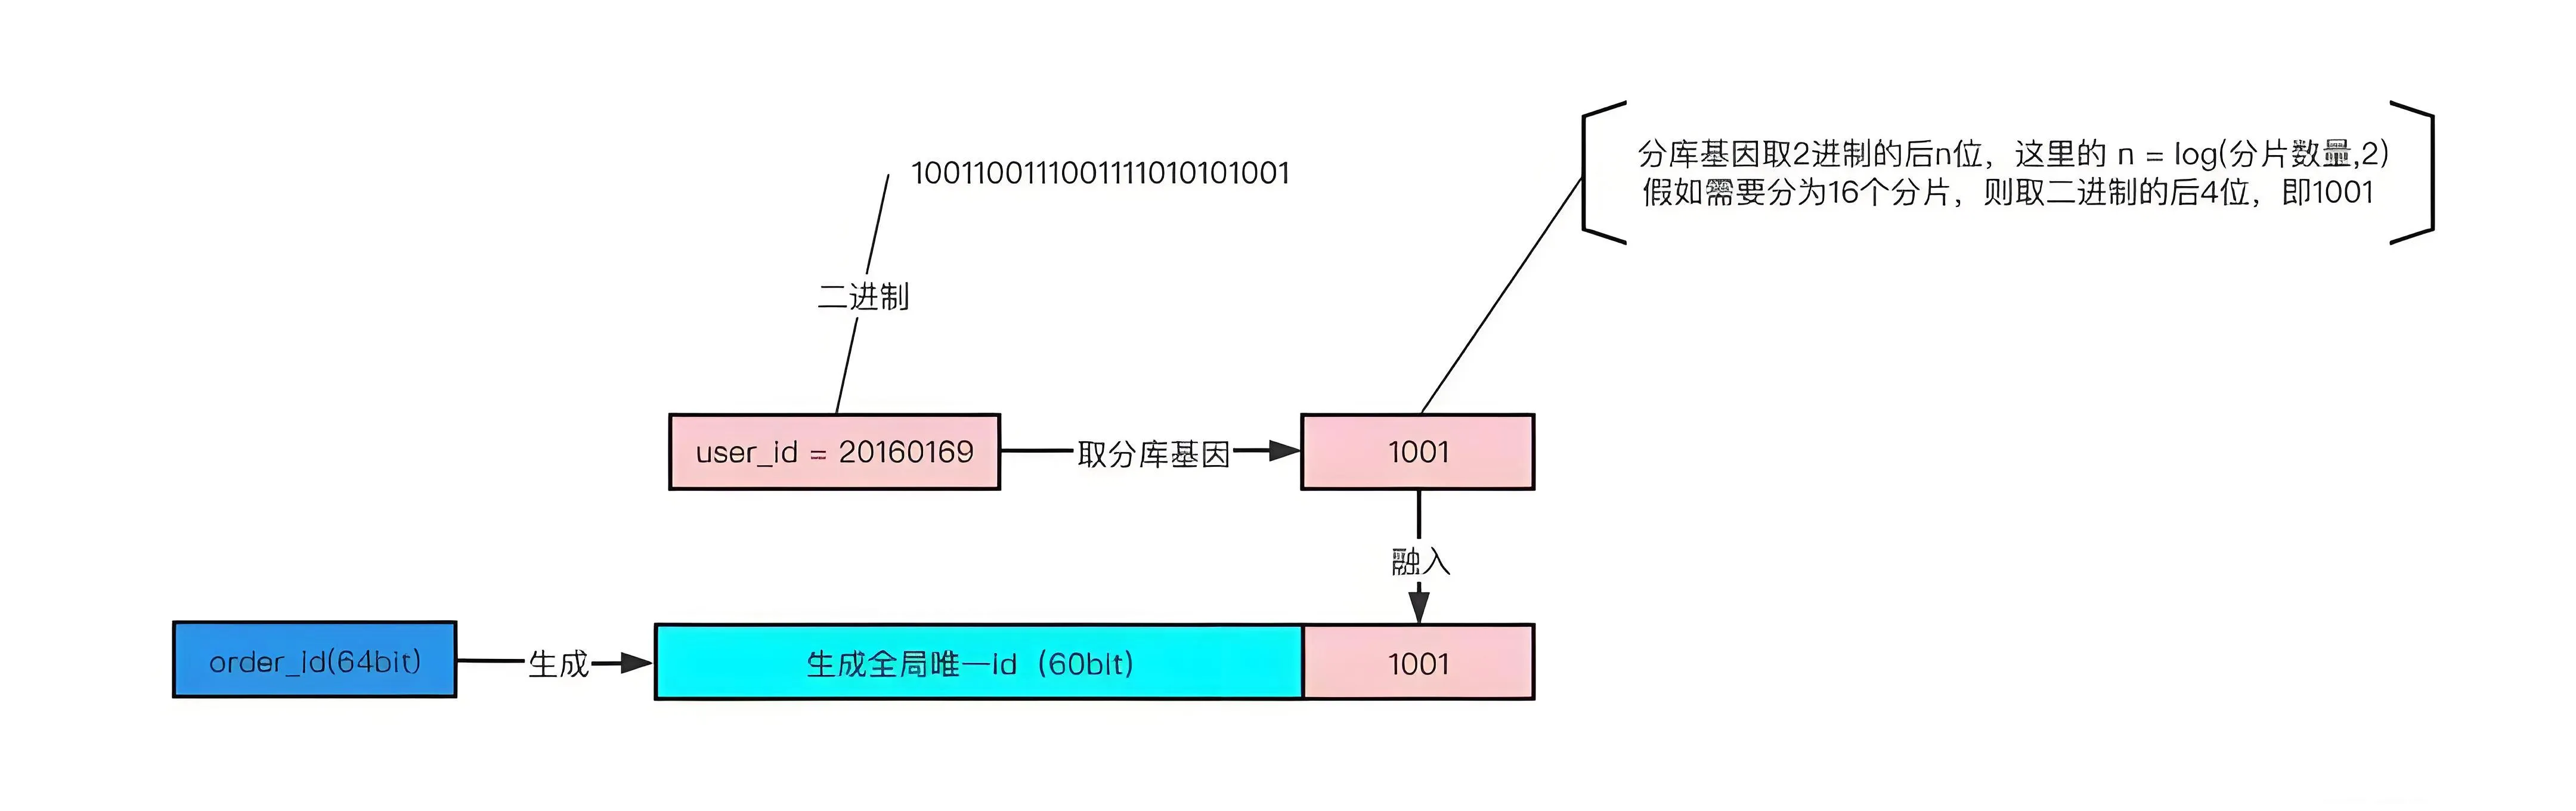
如上图所示,user_id=20160169的用户创建了一个订单(20160169的二进制表示为:1001100111001111010101001) • 使用user_id%16分片,决定这行数据要插入到哪个分片中 • 分库基因是user_id的最后4个bit,log(16,2) = 4,即1001 • 在生成order_id时,先使用一种分布式ID生成算法生成前60bit(上图中绿色部分) • 将分库基因加入到order_id的最后4个bit(上图中粉色部分) • 拼装成最终的64bit订单order_id(上图中蓝色部分) 这样保证了同一个用户创建的所有订单都落到了同一个分片上,order_id的最后4个bit都相同,于是: • 通过user_id %16 能够定位到分片 • 通过order_id % 16也能定位到分片 不好理解的话,可以看下面这段代码:
::: tip提示 log(16,2) 表示以 16 为底数、2 为真数的对数,即求 16 的多少次方等于 2。
根据对数定义,这等价于解方程 (16^x = 2)。由于 (16 = 2^4),所以 (16^x = (24)x = 2^{4x})。令 (2^{4x} = 2^1),则 (4x = 1),解得 (x = \frac{1}{4})。 2
因此,log(16,2) 的值是 ( \frac{1}{4} ) 或 0.25。 :::
另一篇文章
ShardingJDBC(现通常指 Apache ShardingSphere)中的基因法是一种用于数据分片的策略,特别适用于需要基于多个字段进行查询的场景。其核心思想是通过在数据的分片键中嵌入“基因”信息,确保相同业务逻辑的数据(如同一用户的订单)被分配到相同的分片上,从而支持高效的多字段查询。 1 2
基因法的基本原理 基因法基于数学特性:对一个数取余 (2^n) 时,余数等于该数二进制表示的最后 (n) 位。 2 例如,如果分片数量为 4(即 (2^2)),则取余结果的范围是 0 到 3,对应二进制的最后两位(00、01、10、11)。在分片中,基因法通常通过以下方式实现:
分片键设计:选择一个或多个分片键(如 user_id 或 order_id),并将这些键的值通过哈希或取余运算生成分片索引。 基因嵌入:在数据生成时(如订单创建),将分片键的哈希值的低 (n) 位作为“基因”附加到数据中(例如,嵌入到 order_id 的末尾)。这样,同一 user_id 的所有订单会继承相同的基因,从而保证它们被路由到同一分片。 1 2 路由规则:查询时,ShardingSphere 会从分片键中提取基因信息,直接计算出目标分片,避免全表扫描。 具体实现示例 以下以订单表分片为例,展示基因法的配置和代码逻辑(基于 ShardingSphere-JDBC):
分片配置:
假设按 user_id 分表,分片数量为 4。 使用自定义复合分片算法,结合 user_id 和 order_id 作为分片键。 2
Copy Code
# application.yml 配置分片规则
spring:
  shardingsphere:
    rules:
      sharding:
        tables:
          t_order:
            actual-data-nodes: ds0.t_order_$->{0..3} # 分片表为 t_order_0 到 t_order_3
            table-strategy:
              complex:
                sharding-columns: user_id, order_id
                sharding-algorithm-name: t_order_complex_custom_algorithm
        sharding-algorithms:
          t_order_complex_custom_algorithm:
            type: CLASS_BASED
            props:
              strategy: complex
algorithmClassName: com.example.GeneComplexKeysShardingAlgorithm自定义分片算法:
在算法类中,优先使用 user_id 计算分片,若不存在则从 order_id 的基因部分提取信息。
Copy Code
public class GeneComplexKeysShardingAlgorithm implements ComplexKeysShardingAlgorithm {
    @Override
    public Collection<String> doSharding(Collection<String> availableTargetNames, ComplexKeysShardingValue shardingValue) {
        int count = availableTargetNames.size();
        // 确保分片数为 2 的幂次(如 2、4、8)
        if ((count & (count - 1)) != 0) {
            throw new IllegalArgumentException("分片数量必须是 2 的整数次幂");
        }
        List<String> result = new ArrayList<>();
        Map<String, Collection<Comparable<?>>> map = shardingValue.getColumnNameAndShardingValuesMap();
        // 优先使用 user_id 分片
        if (!map.get("user_id").isEmpty()) {
            Long userId = map.get("user_id").stream().findFirst().get();
            int index = (int) (userId % count);
            result.add(availableTargetNames.stream().toList().get(index));
        } else {
            // 从 order_id 的基因部分分片(假设基因占最后 2 位)
            String orderId = map.get("order_id").stream().findFirst().get().toString();
            String gene = orderId.substring(orderId.length() - 2); // 提取基因
            int index = Integer.parseInt(gene) % count;
            result.add(availableTargetNames.stream().toList().get(index));
        }
        return result;
    }
}
基因法的优势与适用场景 优势: 支持多字段查询:通过基因嵌入,即使查询条件包含非分片键(如 order_id),也能快速定位分片。 避免数据倾斜:基因法结合哈希取余,