
数据库- Mysql 索引原理与高性能调优
查询索引时的优化
1、索引的排序与最左前缀原则
索引创建完成后,要考虑的是查询过程中索引的命中率问题。这个时候该我们的 最左前缀原则 上场了
只有当索引的列顺序和 ORDER BY 列的顺序完全一致,并且所有列的排序方向都一样时,MySQL 才能够使用索引来对结果做排序
如果查询需要关联多张表,则只有当 ORDER BY 子句引用的字段全部为第一个表时,才会使用索引做排序
::: tip提示 【推荐】如果有 order by 的场景,请注意利用索引的有序性。order by 最后的字段是组合索引的一部分,并且放在索引组合顺序的最后,避免出现 file_sort 的情况,影响查询性能。
正例: where a=? and b=? order by c; 索引 a_b_c
反例: 索引中有范围查找,那么索引有序性无法利用,如: WHERE a>10 ORDER BY b; 索引 a_b 无法排序。 :::
有一种情况下 ORDER BY 子句可以不满足索引的最左前缀,就是前导列为常数的时候,如果 WHERE 子句或者 JOIN 子句中对这些列指定常量,就可以“弥补”索引的不足,查询为索引的第一列提供了常量条件,而使用第二列进行排序,将两列组合在一起,就形成了索引的最左前缀
示例:索引 (rental_date, inventory_id, customer_id)

# 第一列是常量 + 第二列 order by,查询命中索引没问题
...... where rental_date = '2005-05-25' order by inventory_id desc;


# order by 使用的两列是索引的最前列,符合最左前缀
...... where rental_date > '2005-05-25' order by rental_date, inventory_id desc;
2、支持多种过滤条件(不要建立过多索引)
当设计索引时,不要只为现有的查询考虑需要哪些索引,还需要考虑对其他查询进行优化
如果发现某些查询需要创建新索引,但是这个索引又会降低另一些查询的效率,那么应该想一下是否能优化原来的查询
应该同时优化查询和索引以找到最佳平衡,而不是闭门造车去设计最完美的索引
如果在查询中没有使用某个索引的第一列,可以通过在查询条件中新增 sex in(0,1),来让MySQL选择该索引,必须加上最前列的条件,才能够匹配索引的最左前缀
示例:索引 (sex, country)

...... where sex in (0,1)  and country = '北京';
3、避免多个范围条件
对于范围条件查询,MySQL无法使用范围列后面的其他索引列了,但是对于 “多个等值条件查询” 则没有这个限制
4、如果一个查询匹配的结果有上百万行,对那些选择性非常低的列会怎样?
可以增加一些特殊的索引来做排序,优化这类索引的比较好的策略是使用 延迟关联,
分页靠后时,通过使用覆盖索引查询返回需要的主键,根据主键关联原表获得需要的行,减少 MySQL 扫描后丢弃的行数
# 优化排序: 根据筛选条件 order by 后查出主键,通过主键进行范围查询
select id from tunnel
	inner join (
	    select
	        p.id from tunnel p
	    where
	        p.SEX = 'M' order by p.rating limit 10000, 10
	) as x using (id)

# 优化查询:将原本的连接查询改为子查询,查询对应需要的数据列:
select a.*,
    (select t.tunnel_name from tunnel t where t.tunnel_id = a.t.tunnel_id) from sensor a
::: tip提示 【推荐】利用延迟关联或者子查询优化超多分页场景。
说明: MySQL 并不是跳过 offset 行,而是取 offset+N 行,然后返回放弃前 offset 行,返回 N 行,那当 offset特别大的时候,效率就非常的低下,要么控制返回的总页数,要么对超过特定阈值的页数进行 SQL 改写。
正例: 先快速定位需要获取的 id 段,然后再关联: SELECT a.* FROM 表 1 a, (select id from 表 1 where 条件 LIMIT 100000,20 ) b where a.id=b.id :::
索引和表维护优化
1、找到并修复损坏的表
表损坏通常是系统崩溃导致的,其他的引擎也会由于硬件问题、MySQL 本身的缺陷或者操作系统的问题导致索引损坏。损坏的索引会导致查询返回错误的结果或者莫须有的主键冲突等问题,严重时还会导致数据库的崩溃。
如果你遇到了一些古怪的问题 - 例如一些不应该发生的错误,可以尝试运行 check table 表名,来检查是否发生了表损坏,check table 通常能够找出大多数的表和索引的错误
2、更新索引的统计信息
统计信息不准确一般会导致 MySQL 优化器无法选择正确的索引,从而导致优化器选择错误的索引或者不走索引,引起索引失效,导致大量慢查询。
可以通过 show index from 表名 命令来查看索引基数,可以通过 analyze table 表名 来重新生成统计信息来解决这个问题。
推荐文章: [一招快速解决mysql innodb表索引统计信息不准确问题][3]
3、减少索引和数据的碎片
B-Tree 索引可能会碎片化,降低查询的效率。碎片化的索引会很差或者无序的方式存储在磁盘上。如果叶子页在物理分布上是顺序且紧密的,那么查询的性能会更好。否则对于范围查询,索引覆盖扫描等操作来说,速度会降低很多倍,对于索引的覆盖扫描这一点会更加明显。
表的数据存储也会碎片化。有三种碎片类型:
- 行碎片
- 行间碎片
- 剩余空间碎片
查看某个表的碎片大小:SHOW TABLE STATUS like '表名' , Date_free 列就是就是碎片大小
可以通过 optimize table 表名 或者 导出在导入的方式 来重新整理表。
对于那些不支持 optimize table 的存储引擎,可以使用通过 alter table 表名 engine = 存储引擎 的操作来重建表
如何判断一个系统创建的索引是否合理?
一般来说,我们建议响应时间来对查询进行分析。找出那些消耗最长时间的查询或者那些给服务器带来最大压力的查询,然后检查这些查询的 schema、SQL和索引结构,判断是否有查询扫描了太多的行,是否做了很多额外的排序或者使用了临时表(
Extra列且显示Using temporary),是否使用随机I/O访问文件,或者是有太多回表查询那些不在索引中的列的操作。
索引失效的场景
1、索引列参与运算或使用函数
在SQL语句中,对索引字段做函数操作时,会放弃了索引的树搜索功能,只使用了全索引扫描。
2、类型与字符集不一致
普通查询或者 JOIN 连接的字段如果 类型不一致 ,也会导致索引失效。例如: 用户表中的 userId 字段是字符串类型,查询的时候使用整数类型;在例如连接查询的时候,订单表中的 userId 是整型类型,当关联查询的时候;MySQL 都会使用 cast()函数进行类型的隐式转换,而使用函数就会导致索引失效
::: tip提示 【强制】超过三个表禁止join。需要 join的字段,数据类型必须绝对一致;多表关联查询时,保证被关联的字段需要有索引。
说明:即使双表 join 也要注意表索引、SQL 性能。
【推荐】防止因字段类型不同造成的隐式转换,导致索引失效。 :::
当进行联表查询时,如果关联字段对应的两张表各自的字符集不同,会将字段进行字符集转换,这里字符集转换用的是内部函数操作,此时优化器会放弃走树搜索的功能,会导致索引失效。
3、范围查询没有放到最右列
当索引列范围查询放在索引列常量查询之前时,会导致范围查询右侧的索引列失效。
对于索引中的字段,MySQL会一直向右匹配直到遇到范围查询(>、<、between、in、like)就会停止匹配。
4、使用 or 时前后存在非索引的列
5、使用 is not null 查询索引的列
IS NULL 可以使用索引,但是 IS NOT NULL 无法使用索引
查询优化
优化数据访问
查询性能低下最基本的原因是访问的数据太多。对于低效的查询,会给服务器带来额外的I/O、内存和CPU的消耗。可以通过以下两个步骤分析:
- 确认应用程序是否检索大量不需要的数据。意味着访问了太多的行,有时候也可能访问了太多的列
- 确认 MySQL 服务器是否在分析大量超过需要的数据行。
1、是否向数据库请求了不需要的数据
总是 select * 取出全部的列,多表关联时返回全部列,会让优化器无法完成覆盖索引扫描这类的优化。
2、是否扫描额外的记录
理想情况下扫描的行数跟返回的行数应该是相同的。
Explain 结果中 rows 列也显示了 MySql 预估需要访问的数据行。一个合适的索引能让 MySQL 以最高效、扫描行数最少的方式找到需要的记录。
当 Extra 列显示 Using where 的时候,表示 MySQL 服务层将通过 WHERE 条件来筛选存储引擎返回的记录。
3、重构复杂的关联查询
对于一个大查询我们需要”分而治之“,将大查询分为小查询,每个功能完全一样,只完成一小部分,每次只返回一小部分查询结果。
删除旧数据时如果用一个大的语句一次性完成的话,则可能需要一次锁住很多数据,占满整个事务日志、耗尽系统资源、阻塞很多小的但重要的查询。将一个大的 DELETE 语句切分成多个较小的查询可以尽可能小地影响 MySQL 性能。
很多高性能的应用都会对关联查询进行分解。可以对每一个表进行一次单表查询,然后将结果在应用程序中进行关联。
# 示例:
    select * from tag
        join tag_post on tag_post.tag_id = tag.id
        join post on tag_post.post_id = post.id
        where tag.tag = 'mysql'

# 可以插接成下面这些查询来代替:
    select * from tag where tag = 'mysql'
    select * from tag_post where tag_id = 1234
    select * from post where post.id in (123,456,9098,8904)
4、MySQL 是如何优化和执行查询的
MySQL服务器的逻辑架构:
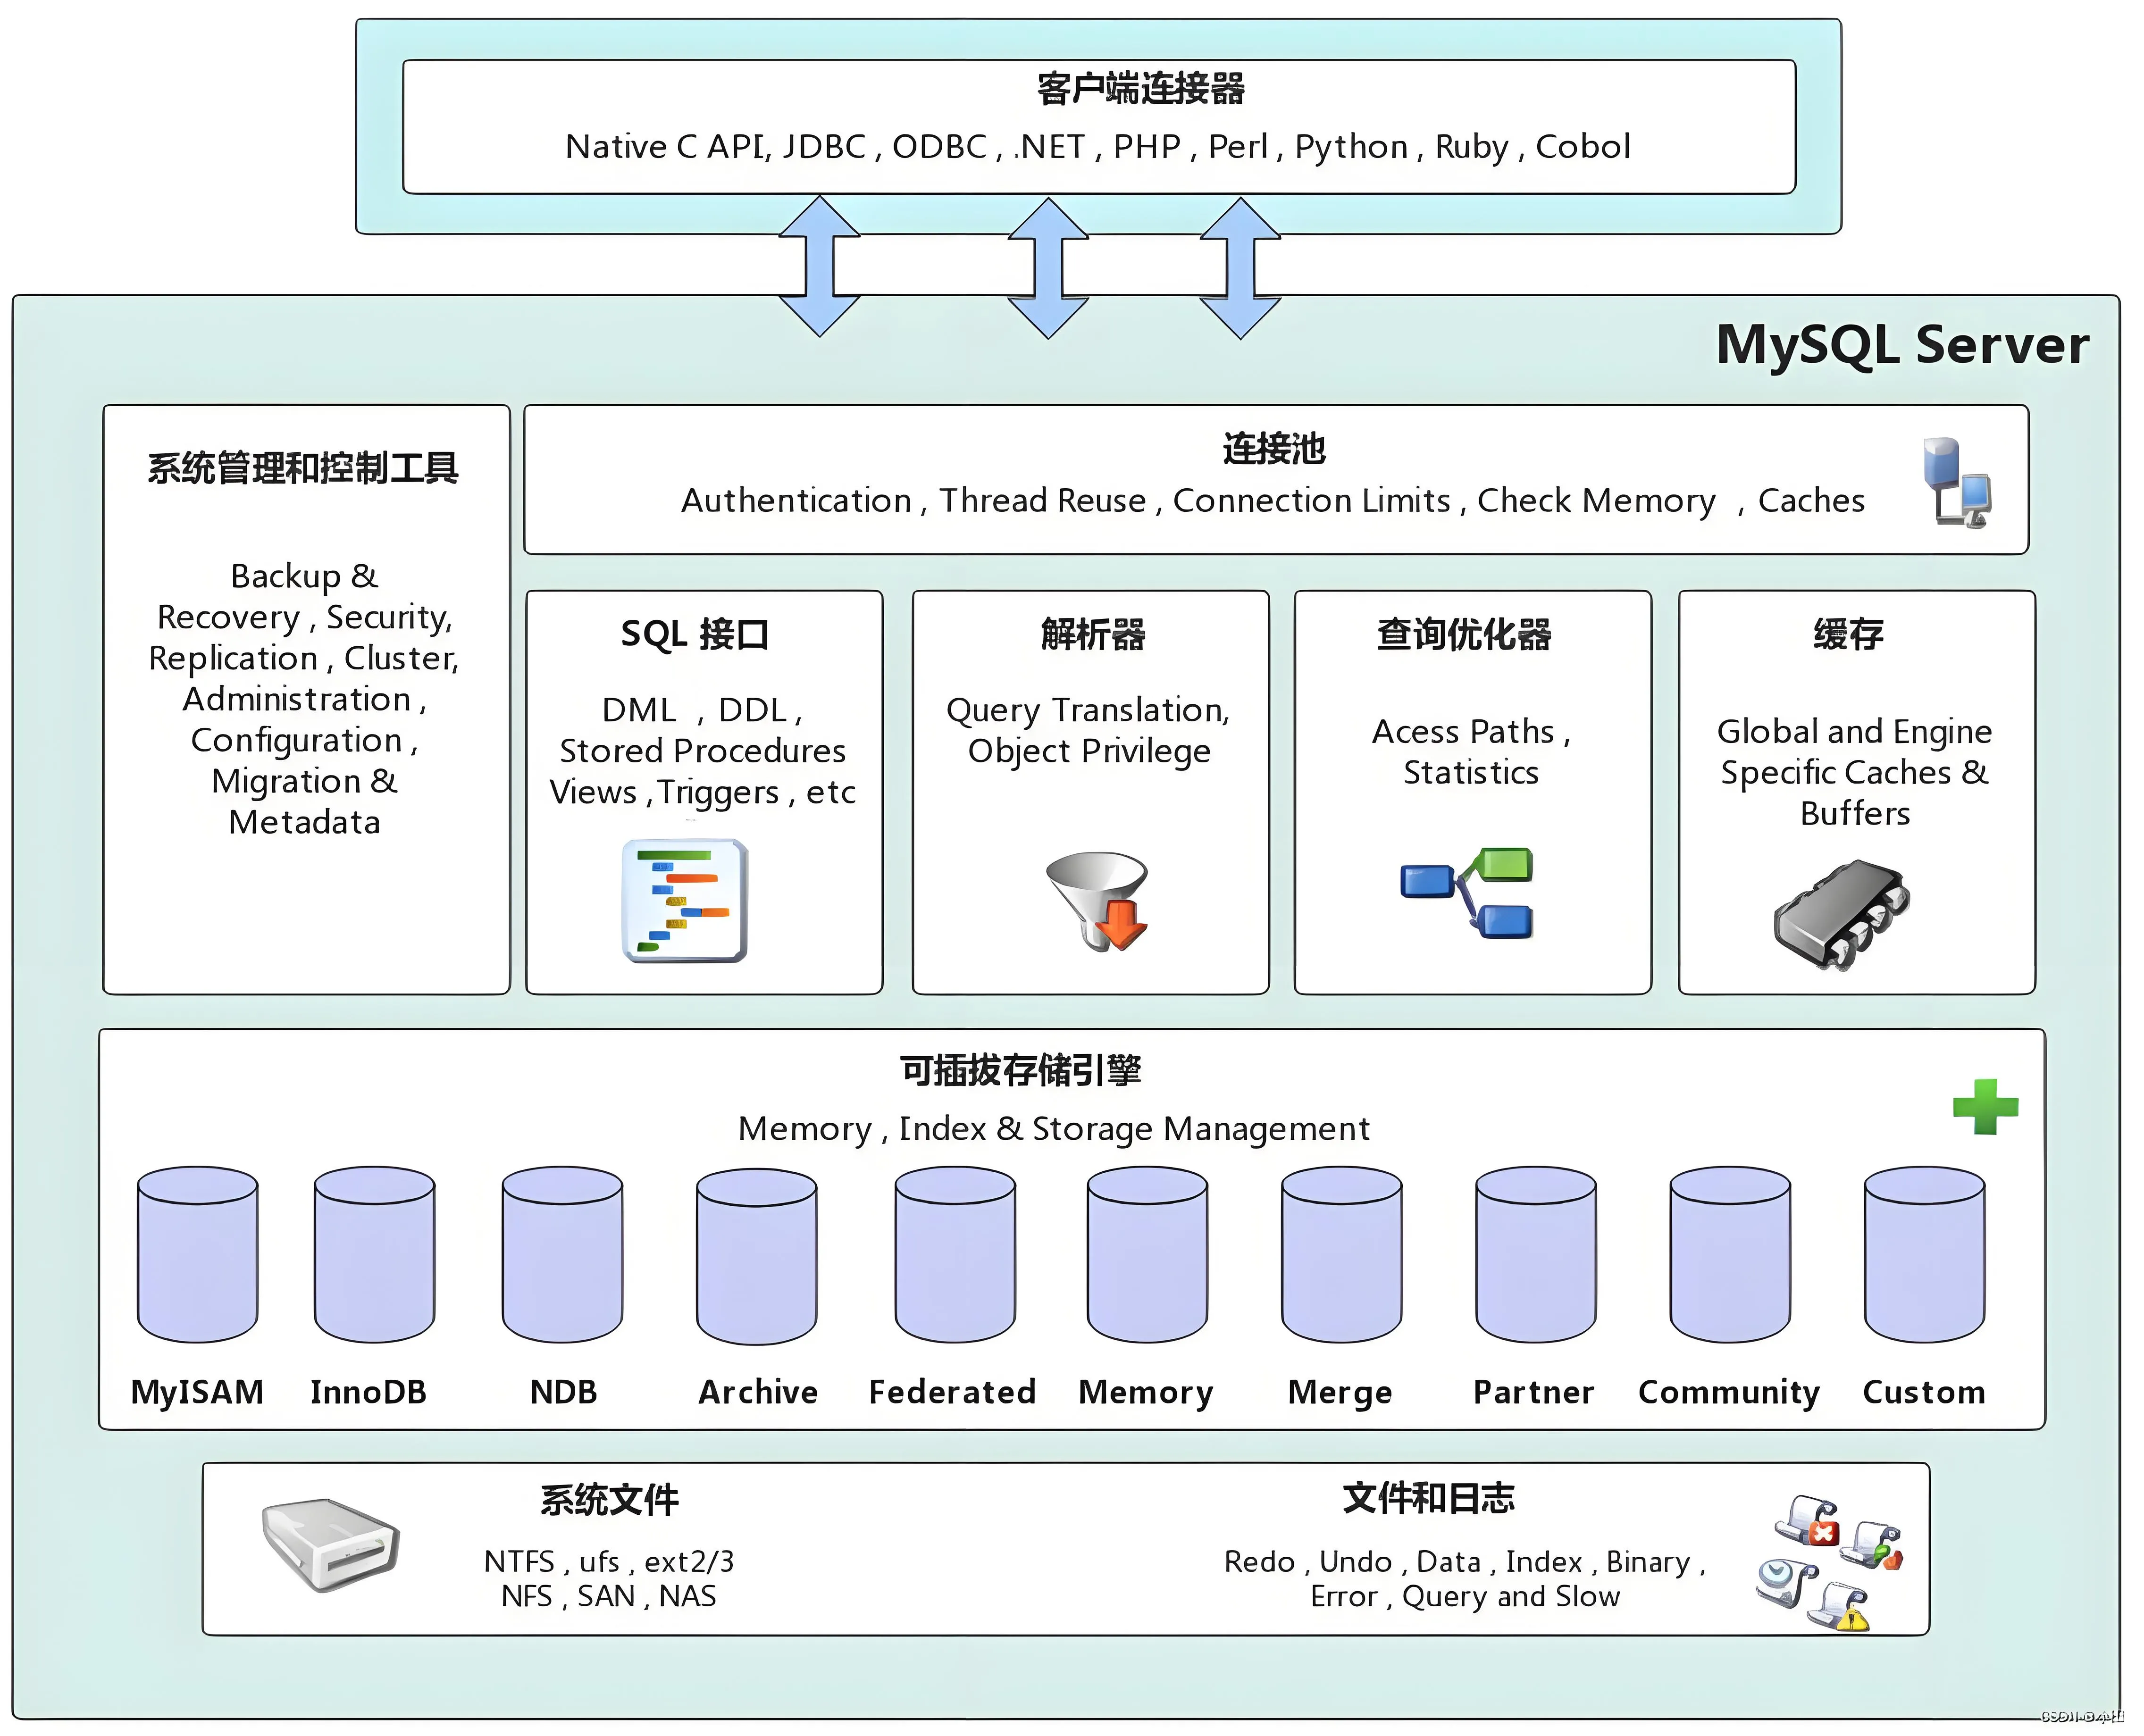
- 第一层:处理客户端连接、授权认证等
- 第二层:服务器层,负责查询语句的解析、优化、缓存以及内置函数的实现、存储过程等
- 第三层:存储引擎,负责MySQL中数据的存储和提取。
MySQL 执行一个查询的过程:
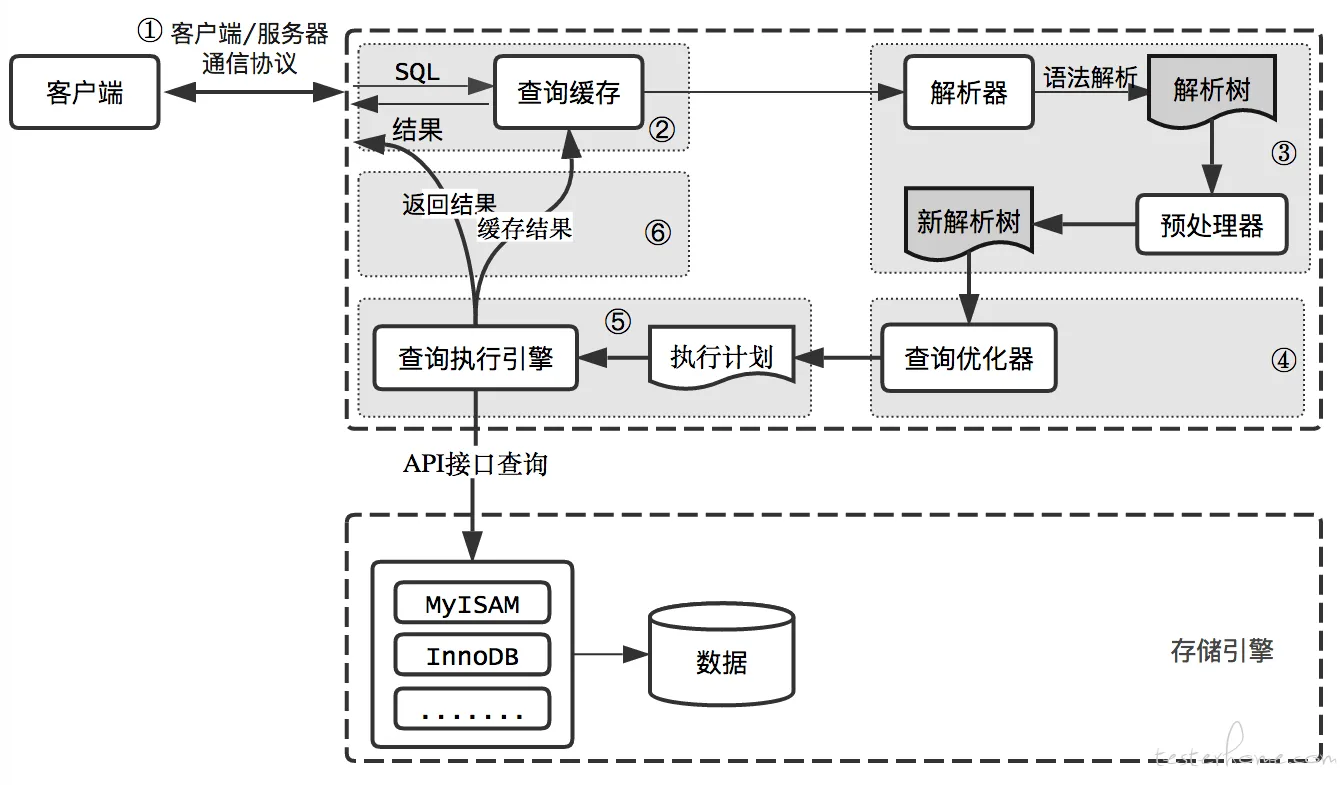
- 客户端发送一条查询给服务器
- 服务器先检查查询缓存,如果命中了缓存,则立刻返回缓存中的结果
- 服务器端进行 SQL 解析、预处理、再由优化器生产对应的执行计划
- MySQL 根据优化器生产的执行计划,调用存储引擎的API来执行查询
- 将结果返回给客户端
5、优化特定类型的查询
1)COUNT()的作用和优化
可以统计某个列值的数量,在统计列值时要求列值是非空的(不统计 NULL )
如果在 COUNT() 的括号中指定了列的表达式,则统计的就是这个表达式的有值的结果数
COUNT() 的另一个作用就是统计结果集的行数,最简单的就是当我们使用 COUNT() 的时候,实际上,它会忽略所有的列而直接统计所有的行数。如果希望知道的是结果集的行数,最好使用 COUNT(),这样写意义清晰,性能也会很好。
最常见的错误:在括号内指定列却希望统计结果集的行数。
MyISAM 的 COUNT(*) 函数非常快,不过前提是没有任何的 WHERE 条件,因为此时无需实际地去计算表的行数,MySQL 可以利用存储引擎的特性直接获取这个值
::: tip提示 【强制】不要使用 count(列名)或 count(常量)来替代 count(),count()是 SQL92 定义的 标准统计行数的语法,跟数据库无关,跟 NULL 和非 NULL 无关。
说明: count(*)会统计值为 NULL 的行,而 count(列名)不会统计此列为 NULL 值的行。
【强制】count(distinct col) 计算该列除 NULL 之外的不重复行数,注意 count(distinct col1, col2) 如果其中一列全为NULL,那么即使另一列有不同的值,也返回为0。 :::
简单优化:
可以直接使用 MyISAM 在 COUNT(*) 全表非常快的这个特性。
也可以条件反转查询行数,比如id大于5的城市数量,可能有几千条,我们取总数减去小于5的城市就能得到同样的结果,而且将扫描的行数减少到5以内
假设可能需要通过一个查询返回各种不同颜色的商品数量:
SELECT SUM(IF(color = 'blue',1,0)) AS blue, SUM(IF(color = 'red',1,0)) AS red FROM items;
也可以使用 COUNT() 而不是 SUM(),满足条件设置为真,不满足设置为NULL即可。
SELECT COUNT(color = 'blue' OR NULL) AS blue,COUNT(color = 'red' OR NULL) AS red FROM items;
某些业务场景并不要求完全精确的 COUNT值,此时可以使用近似值来代替。EXPLAIN 出来的优化器估算的行就是一个不错的近似值,执行 EXPLAIN 并不需要真正的去执行查询。
更复杂的优化:
通常来说,COUNT() 都需要扫描大量的行才能获取精确结果,因此很难优化
除了前面的方法, 在 MySQL 层面还能做的就是使用覆盖索引扫描了
还不够的话,就需要考虑修改应用的架构,可以添加汇总表,或者增加类似 Memcached 这样的外部缓存系统。
2)优化关联查询
确保 ON 或者 USING 子句上有索引,在创建索引的时候就要考虑关联的顺序。
一般来说,除非有其他理由,否则只需要在关联循序中的第二个表的相应列上创建索引。
3)GROUP BY 和 DISTINCT 优化
Mysql 优化器会在内部处理的时候相互转化这两类查询,当无法使用索引的时候,GROUP BY 使用两种策略来完成:使用临时表或者文件排序来做分组。
如果没有通过 ORDER BY 子句显式的置顶排序列,当查询使用 GROUP BY 子句的时候,结果集会自动按照分组的字段来进行排序。如果不关心结果集的顺序,而这种默认排序又导致了文件排序,则可以使用 ORDER BY NULL, 让 MySQL 不再进行文件排序。
4)其他
【推荐】表的命名最好是加上“业务名称_表的作用”。
正例:alipay_task / force_project / trade_config
【推荐】表的命名最好是加上“业务名称_表的作用”。
【强制】表名、字段名必须使用小写字母或数字,禁止出现数字开头,禁止两个下划线中间只 出现数字。数据库字段名的修改代价很大,因为无法进行预发布,所以字段名称需要慎重考虑。 说明:MySQL 在 Windows 下不区分大小写,但在 Linux 下默认是区分大小写。因此,数据库名、 表名、字段名,都不允许出现任何大写字母,避免节外生枝。
正例:aliyun_admin,rdc_config,level3_name
反例:AliyunAdmin,rdcConfig,level_3_name
【强制】使用 ISNULL()来判断是否为 NULL 值。
说明: NULL 与任何值的直接比较都为 NULL。
1)  NULL<>NULL的返回结果是NULL,而不是false。
2)  NULL=NULL的返回结果是NULL,而不是true。
3)  NULL<>1的返回结果是NULL,而不是true。
【推荐】单表行数超过 500 万行或者单表容量超过 2GB,才推荐进行分库分表。
说明:如果预计三年后的数据量根本达不到这个级别,请不要在创建表时就分库分表。
库表优化
选择优化的数据类型
更小的通常更好
应该尽量使用可以正确存储数据的最小数据类型,更小的数据类型通常更快,因为它们占用更少的磁盘、内存和CPU缓存,并且处理时需要的CPU周期更少
但是要确保没有低估需要存储的值的范围,如果无法确认哪个数据类型,就选择你认为不会超过范围的最小类型
::: tip提示 【强制】表达是与否概念的字段,必须使用 is_xxx 的方式命名,数据类型是 unsigned tinyint (1 表示是,0 表示否)。
说明:任何字段如果为非负数,必须是 unsigned。
注意: POJO 类中的任何布尔类型的变量,都不要加 is 前缀,所以,需要在<resultMap> 设置 从 is_xxx 到 Xxx 的映射关系。数据库表示是与否的值,使用 tinyint 类型,坚持 is_xxx 的 命名方式是为了明确其取值含义与取值范围。
正例: 表达逻辑删除的字段名 is_deleted,1 表示删除,0 表示未删除。 :::
类型简单就好
简单数据类型的操作通常需要更少的CPU周期,例如:
1、整型比字符操作代价更低,因为字符集和校对规则是字符比较比整型比较更复杂,能用整型的就不要用字符类型
2、使用Mysql 内建的类型而不是字符串来存储日期和时间
3、用整型存储IP(IPv4地址实际上是32位无符号整数,不是字符串,使用小数点将地址分成4段只是为了让人们阅读容易。所以应该使用无符号整数存储 IP地址)MySQL 提供 INET_ATON() 和 INET_NTOA() 函数在这两种表示方法之间转换
尽量避免 NULL
通常情况下可为 NULL 的列改为 Not NULL带来的性能提升比较小,所有(调优时)没有必要首先在现有schema中查找并修改掉这种情况,除非确定这会导致问题。
如果计划在列上建索引,就应该避免设计成可 NULL的列,因为可为 NULL 的列使得索引、索引统计和值比较都更加复杂
MySQL数据类型
整数类型:
tinyint(2^8)、 smallint(2^16)、 mediumint(2^24)、 int(int类型是 2^32次方,42亿数值完全够用,占用空间是4字节) bigint(2“64次方,占用空间 8字节)。存储数据的大小是相同的,但是类型不同表空间实际占用的内存空间大小也不同
| 数据类型 | 空间(Bytes) | 带符号最小值 | 带符号最大值 | 不带符号最小值 | 不带符号最大值 |
|---|---|---|---|---|---|
| TINYINT | 1 | -128 | 127 | 0 | 255 |
| SMALLINT | 2 | -32768 | 32767 | 0 | 65535 |
| MEDIUMINT | 3 | -8388608 | 8388607 | 0 | 1677215 |
| INT | 4 | -2147483648 | 2147483648 | 0 | 4294967295 |
| BIGINT | 8 | 0 |
数据范围:带符号 最小值~最大值公式
~
数据范围:不带符号 最小值~最大值公式
0 ~
::: tip使用整数类型 INT(10) 和 INT(20) 有什么区别? MySQL 可以为整数类型指定宽度,例如 INT(10),对大多数应用这是没有意义的,它不会限制值的合法范围,对于存储与计算来说 INT(10) 和 INT(20) 是相同的 :::
实数(浮点数)类型:
FLOAT 和 DOUBLE 类型支持使用标准的浮点运算进行近似计算
DECIMAL 类型用于存储精确的小数,可以指定小数点前后所允许的最大位数,这会影响列的空间消耗.每4个字节存9个数字,例如 DECIMAL(18,9),小数点两边各存储9个数字,一共使用9个字节。小数点前的数字用4个字节,小数点后的数字用4个字节,小数点本身占1个字节
浮点类型在存储同样范围的值时,通常比 DECIMAL 使用更少的空间。 FLOAT 使用4个字节存储,DOUBLE 占用8个字节。
应该尽量只在对小数进行精确计算时才使用 DECIMAL,例如:存储财务数据可考虑使用 BIGINT 替代 DECIMAL,将需要存储的货币单位根据小数的位数乘以相应的倍数即可。这样可以避免浮动存储计算不精确和 DECIMAL 精确计算代价高的问题。电商场景中,金额的精度计算,单位精确到 ‘分’存储,可以把100作为倍数,金额乘以100,以 ‘分’ 为单位,存储整数类型
::: tip提示 【强制】小数类型为 decimal,禁止使用 float 和 double。
说明:float 和 double 在存储的时候,存在精度损失的问题,很可能在值的比较时,得到不 正确的结果。如果存储的数据范围超过 decimal 的范围,建议将数据拆成整数和小数分开存储。 :::
字符串类型:
VARCHAR
类型用来存储可变长度字符串,是最常见的字符串数据类型。它比定长类型更节省空间,因为它仅使用必要的空间。 需要使用1或2个额外字节记录字符串的长度,如果长度小于或等于255字节,则使用1个字节,否则使用2个字节。
::: tip使用 VARCHAR(5) 和 VARCHAR(200) 存储 ‘hello’ 的空间开销是一样的,那么使用更短的列有什么优势吗? 有很大的优势。更长的列消耗更多的内存,因为 MySQL 通常分配固定大小的内存块来保存内部值,尤其内存临时表进行排序或操作时会特别糟糕,所以最好的策略是只分配真正需要的空间。 :::
CHAR
类型是定长的,MySQL 根据定义的字符串长度分配足够的空间,当存储 CHAR 值时,会删除所有的末尾空格。适合存储很短的字符串,或者所有值都同一个长度。例如:存储MD5值、使用 CHAR(1) 来存储 Y 和 N 的值。
::: tip提示 【强制】如果存储的字符串长度几乎相等,使用 char 定长字符串类型。
【强制】varchar 是可变长字符串,不预先分配存储空间,长度不要超过 5000,如果存储长 度大于此值,定义字段类型为 text,独立出来一张表,用主键来对应,避免影响其它字段索 引效率。 :::
大字段类型:
BLOB 和 TEXT、 都是为存储很大的数据而设计的字符串数据类型,分别采用二进制和字符方式存储
避免使用 BLOB 和 TEXT 类型,如果必须用,也要单独设计表存储
- TEXT:最大长度为65,535字节(约64KB),适用于大多数文本数据存储需求。
- MEDIUMTEXT:最大长度为16,777,215字节(约16MB),适用于需要存储更大文本数据的场景。
- LONGTEXT:最大长度为4,294,967,295字节(约4GB),适用于存储非常大的文本数据。
日期和时间类型:
DATE 类型,TIME 类型,YEAR 类型
日期类型 DATETIME 类型,展现的形式为:YYYY-MM-DD HH:MM:SS 与时区无关,使用8个字节的存储空间
日期类型 TIMESTAMP 类型, 只使用4个字节的存储空间,从 '1970-01-01 00:00:00' 开始,上限到 '2038-01-19 03:14:07',显示值依赖于时区
除特殊行为之外,通常也应该尽量使用 TIMESTAMP , 因为它比 DATETIME 空间效率更高。
::: tip提示 【强制】表必备三字段: id, gmt_create, gmt_modified。
说明:其中id必为主键,类型为bigint unsigned、单表时自增、步长为1。gmt_create, gmt_modified 的类型均为 datetime 类型,前者现在时表示主动创建,后者过去分词表示被动更新。 :::
优化总结
- 尽量避免过度设计,导致复杂查询的 schema 设计,或者有很多列的表设计
- 使用小而简单的合适的数据类型,除非真实数据模型中有确切的需要,否则应该尽可能的避免使用 NULL 值
- 尽量使用相同的数据类型存储相似或相关的值,尤其是要在关联条件中使用的列
- 注意可变长字符串,其在临时表和排序时可能导致悲观的按最大长度分配内存
- 尽量使用整型定义标识列
- 避免使用 MySQL 已经遗弃的特性,例如:指定浮点数的精度,或者整数的显示宽度
- 小心使用 ENUM 和 SET,避免使用 BIT